Doppelte GPU-Effizienz durch Disaggregated Inference ohne Mehrkosten
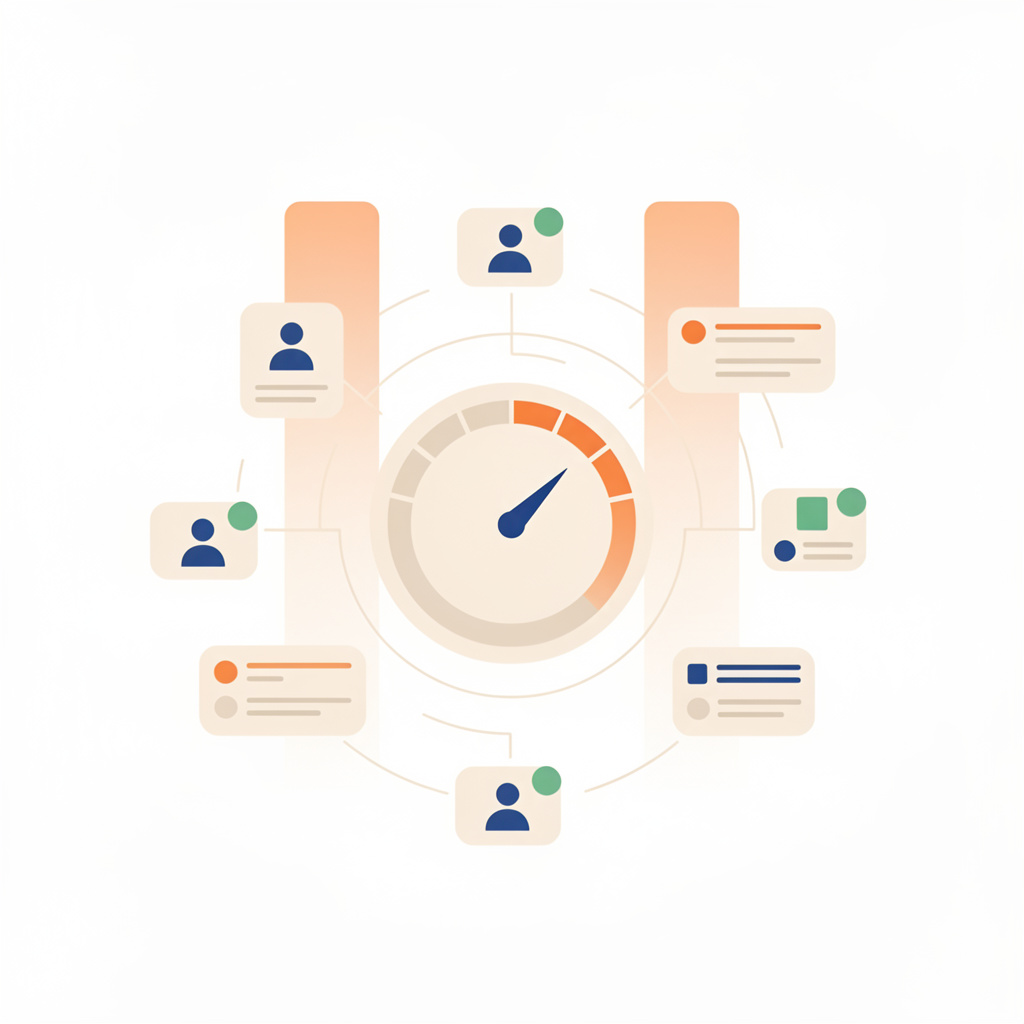
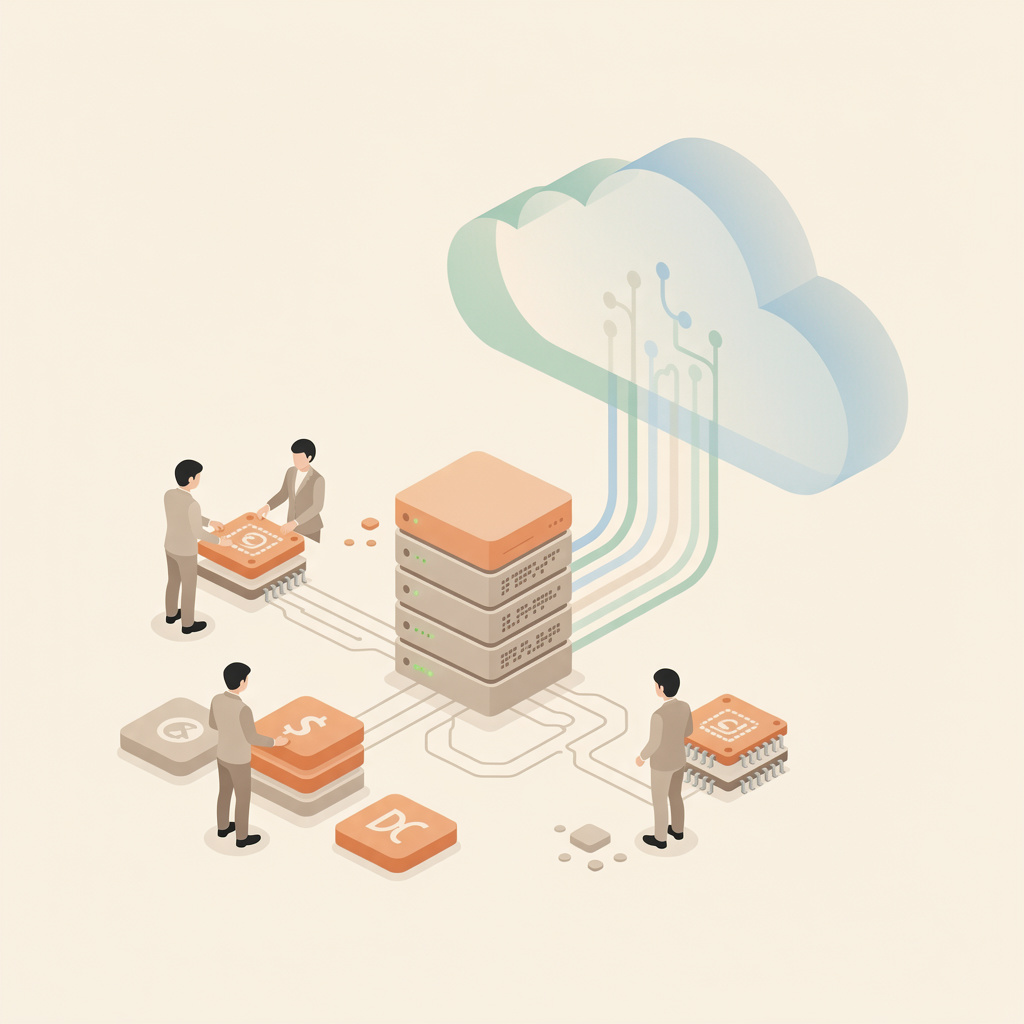
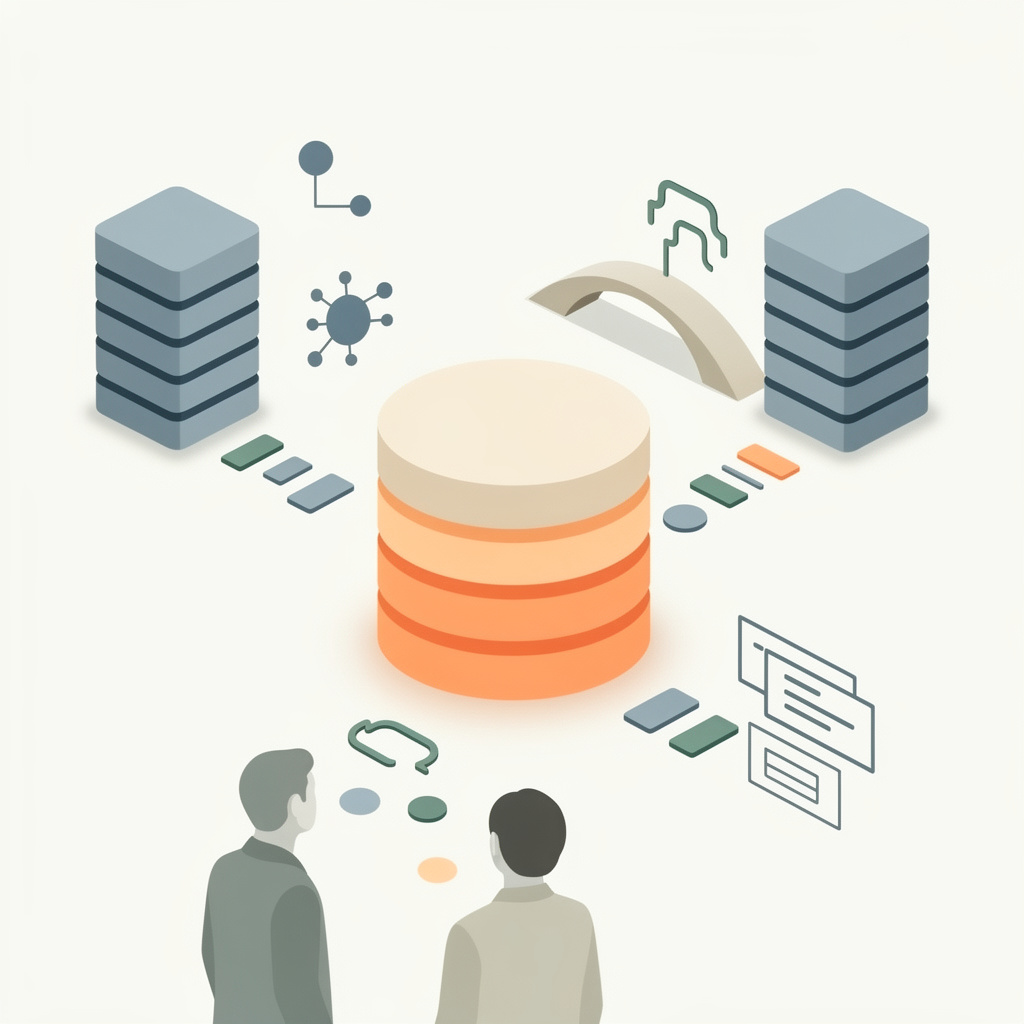
Ein neuer Ansatz zur Aufteilung von KI-Inferenzlasten auf spezialisierte GPU-Pools verspricht erhebliche Effizienzsteigerungen. Die Methode des Disaggregated Inference könnte Unternehmen Hunderttausende Dollar jährlich einsparen.