Was Coral, Hailo, Axelera und die NPU mit Ihrem Prozessoren können
Ellen bemerkt das Problem zuerst am Geräusch.
Der kleine Server unter ihrem Schreibtisch, der eigentlich nur Dateien verwalten und vier Überwachungskameras aufzeichnen soll, läuft seit Wochen mit hochtourigem Lüfter. Sie schaut nach: Die Auslastung liegt konstant bei neunzig Prozent und darüber. Die Ursache ist schnell gefunden. Die Software soll erkennen, ob auf den Kamerabildern ein Mensch, ein Auto oder eine Katze zu sehen ist, und dafür rechnet der Prozessor rund um die Uhr an Bilddaten, für die er nie gebaut wurde.
Ellen sucht nach einer stärkeren CPU und landet stattdessen in einem Forum, wo jemand schreibt, sie solle sich einen Stick für siebzig Euro kaufen.
Sie hält das für einen Scherz. Vier Wochen später läuft ihr Server wieder lautlos, die Auslastung ist deutlich gefallen, und die Erkennung arbeitet zuverlässiger als vorher: Paketbote ja, Ast im Wind nein.
Das ist die Geschichte, die KI-Beschleuniger gut können. Sie hat einen Haken, aber der liegt woanders, als die meisten vermuten. Und der Markt dahinter ist erheblich größer als die zwei, drei Namen, die man in Foren immer wieder liest.
Was diese Geräte eigentlich sind
Die hier behandelten Geräte sind spezialisierte Recheneinheiten, häufig als ASIC ausgeführt, also als Chip, der für eine begrenzte Klasse von Berechnungen optimiert wurde statt für alles Mögliche. Innerhalb dieser Klasse kann er durchaus viele verschiedene Modelle ausführen, und zwar sehr schnell und sehr sparsam. Außerhalb der vorgesehenen Rechenoperationen und Datenformate ist er stark eingeschränkt.
Die Bezeichnungen schwanken. Meist heißt so ein Baustein NPU (Neural Processing Unit), wobei eine NPU auch als Baustein innerhalb eines größeren Chips stecken kann und nicht zwingend ein eigenständiger ASIC ist. Google verwendet für seine Variante den Namen Edge TPU (Tensor Processing Unit).
Der Gegenpol ist die Grafikkarte: universeller, dafür größer, teurer und durstiger. Der Unterschied ist nicht gradueller Natur. Es sind zwei verschiedene Werkzeugarten, und wer sie verwechselt, kauft zwangsläufig falsch.
Ein Vergleich macht das deutlich, wenn man ihn sauber zieht. Ein Beschleunigermodul wie der Hailo-10H benötigt typischerweise rund 2,5 Watt. Das komplette kleine System darum herum, also Platine, Speicher, Netzwerk und Laufwerk, liegt darüber, insgesamt meist im Bereich zwischen zehn und zwanzig Watt.
Der aussagekräftigste Gegenwert ist dabei nicht die Volllast eines großen Rechners, sondern dessen Leerlauf. Denn Dauerbetrieb bedeutet ja gerade, dass ein Gerät die meiste Zeit wartet. Ein von der c’t gemessenes Workstation-System mit vier Grafikkarten zog im Leerlauf 226 Watt aus der Steckdose; die Karten allein kamen dabei jeweils auf über 30 Watt, ohne angeschlossenen Monitor und ohne jede Rechenlast.
Damit steht die Sache so: Ein Beschleunigermodul verbraucht arbeitend weniger als eine Grafikkarte im Leerlauf. Das eine lässt man für eine Aufgabe anlaufen. Das andere läuft das ganze Jahr durch, und man merkt es auf der Stromrechnung kaum
Die Landkarte: vier Kategorien
Wer nach Beschleunigern sucht, stolpert über ein Dutzend Namen ohne erkennbare Ordnung. Tatsächlich lässt sich der Markt grob in vier Gruppen einteilen. Sie unterscheiden sich bei Einsatzzweck, Speicherarchitektur, Softwareunterstützung und in der Frage, ob es sich um einen Zusatzchip oder einen vollständigen Rechner handelt.
Gruppe 1: Vision-NPUs, die große Mehrheit
Das ist der Hauptteil des Markts. Chips, die Bilder verarbeiten, meist im M.2-Format, also in derselben Bauform wie eine kleine SSD.
| Chip | Leistung | Verbrauch | Besonderheit |
|---|---|---|---|
| Hailo-8 | 26 TOPS | wenige Watt | Einer der am weitesten verbreiteten Edge-Beschleuniger, auch als Hailo-8L mit 13 TOPS |
| Axelera Metis | 214 TOPS Spitze | 3,5 bis 9 W | Mit Abstand die höchste Zahl im Feld, 14,7 TOPS pro Watt |
| DEEPX DX-M1 | 25 TOPS | 2 bis 5 W | Bildverarbeitung und Encoder integriert, industrietauglich von -25 bis 85 °C |
| MemryX MX3 | rund 24 TOPS | etwa 2 W | Offene Treiber und offenes SDK, Installation in unter zehn Minuten |
| Kinara Ara-2 | hoher Durchsatz | mittel | Auf Transformer und Mehrmodellbetrieb ausgelegt, inzwischen von NXP übernommen |
Dazu kommen SiMa.ai, Blaize, Ambarella, EdgeCortix, Renesas und ARM Ethos.
Bemerkenswert ist, wie unterschiedlich Chips mit fast identischer Kennzahl arbeiten. DEEPX und Hailo-8 liegen beide im Bereich von 25 bis 26 TOPS, zielen aber auf verschiedene Dinge: DEEPX auf gleichmäßige Latenz pro Einzelbild, Hailo-8 auf stabilen Durchsatz bei mehreren parallelen Kamerastreams. Gleiche Zahl, andere Stärke. Wer vier Kameras gleichzeitig auswertet, will das eine. Wer eine Maschine steuert, das andere.
MemryX verdient einen eigenen Hinweis für alle, die selbst basteln wollen. Der Hersteller positioniert sich mit offen zugänglichen Treibern, offenem SDK und ausführlicher Dokumentation ausdrücklich entwicklerfreundlich, was in diesem Marktsegment bis heute die Ausnahme ist. Der schnellste Chip ist es nicht.
Alle Angaben in dieser Tabelle stammen aus Herstellerunterlagen und veröffentlichten Vergleichstests. Weil sich in diesem Segment Spezifikationen, Softwarestände und sogar Eigentümerverhältnisse schnell ändern, gehört vor jedem Kauf ein Blick ins aktuelle Datenblatt des jeweiligen Anbieters.
Gruppe 2: Die wenigen, die Sprachmodelle können
Hier wird die Luft dünn, und zwar dramatisch.
Bei den meisten Vision-NPUs fehlt derzeit mindestens eine von drei Voraussetzungen: ausreichend eigener Speicher, unterstützte Rechenoperationen für Transformer-Architekturen oder öffentlich verfügbare Modelle in einem passenden Format. Aus einer hohen TOPS-Zahl darf man deshalb keinesfalls schließen, dass generative Sprachmodelle laufen.
Wie eng der Speicher tatsächlich ist, zeigt ein dokumentiertes Beispiel: Bei MemryX stehen rund 10 MB pro Kern zur Verfügung, etwa 40 MB insgesamt über vier Kerne. Für ein Sprachmodell ist das um Größenordnungen zu wenig.
Greifbar für Endkunden ist derzeit vor allem der Hailo-10H, um den es weiter unten ausführlich geht. Weitere Chips verschiedener Hersteller zielen inzwischen ebenfalls auf lokale Sprachmodelle, sind aber überwiegend für Gerätehersteller gedacht und kaum einzeln zu bekommen.
Für die Kaufentscheidung folgt daraus eine einfache Regel: Vor dem Kauf muss für das konkrete Gerät geprüft werden, ob das gewünschte Modell und die benötigte Software offiziell unterstützt werden. Alles andere ist Hoffnung.
Gruppe 3: Die NPU, die Sie wahrscheinlich schon haben
Diese Gruppe wird am häufigsten übersehen und ist die einzige, die nichts kostet.
Moderne Prozessoren bringen eine NPU von Haus aus mit: Intel Core Ultra mit AI Boost, AMD Ryzen AI mit XDNA, Qualcomm Snapdragon X mit Hexagon, Apple mit der Neural Engine. Wer in den letzten zwei Jahren ein Notebook gekauft hat, besitzt mit hoher Wahrscheinlichkeit eine.
Die Frage, ob sich daneben noch ein separater Beschleuniger lohnt, ist inzwischen so verbreitet, dass sie eigene Vergleichsartikel füllt. Die Antwort aus der Industrie fällt differenziert aus: Moderne Prozessoren integrieren zunehmend NPUs für grundlegende Aufgaben, während viele industrielle Anwendungen mehr Flexibilität, höhere Rechendichte oder eine engere Kontrolle über Strom- und Wärmebudget verlangen.
Für den Privatgebrauch heißt das schlicht: Bevor Sie etwas kaufen, sehen Sie nach, was schon da ist.
Gruppe 4: NVIDIA Jetson, ein eigenes Tier
Die Jetson-Reihe fällt aus dem Raster, weil sie kein Zusatzchip für einen Gastgeber ist, sondern ein vollständiger kleiner Rechner mit gemeinsamem Speicher und der CUDA-Umgebung von NVIDIA.
Der praktische Unterschied ist erheblich: Auf einem Jetson steht eine wesentlich breitere Software-Landschaft zur Verfügung, mit CUDA, den gängigen Entwicklungswerkzeugen und normalem Linux. Modelle sind deutlich weniger an einen herstellereigenen Katalog gebunden. Ganz ohne Anpassung geht es allerdings auch hier nicht: Sie müssen zur ARM64-Plattform, zum verfügbaren Speicher und zur jeweiligen Laufzeitumgebung passen, und einzelne Pakete hängen an bestimmten Versionen. Dafür kostet ein Jetson ein Vielfaches der M.2-Module und verbraucht mehr. In Vergleichstests zu lokalen Modellen der 7-Milliarden-Klasse taucht er regelmäßig neben Hailo und RK1828 auf.
Der Klassiker: Coral USB Accelerator
Der Stick, der Ellens Problem gelöst hat, ist mit einiger Wahrscheinlichkeit Googles Coral USB Accelerator. Er leistet vier Billionen Operationen pro Sekunde bei etwa zwei Billionen pro Watt und führt ein gängiges Bildmodell mit über hundert Bildern pro Sekunde aus.
Für Kameraauswertung ist das seit Jahren die Standardlösung. Die Kombination aus Coral und einer Überwachungssoftware wie Frigate ist in Heimnetzen so verbreitet, dass sie praktisch als Referenz gilt.
Was der Coral nicht kann: Text erzeugen. Nicht ein bisschen langsam, sondern überhaupt nicht.
Der Grund ist doppelt. Erstens muss ein Modell als kompatibles TensorFlow-Lite-Modell vorliegen und vom zugehörigen Übersetzungswerkzeug unterstützt werden. MobileNet und Inception sind verbreitete Beispiele, aber nicht die einzigen möglichen Architekturen; eigene Modelle lassen sich ebenfalls übersetzen, sofern ihre Rechenoperationen unterstützt sind. Genau daran scheitern generative Sprachmodelle: Ihre Architektur ist auf diesem Chip schlicht nicht vorgesehen.
Zweitens hat der Chip praktisch keinen eigenen Speicher für Modellgewichte. Er bekommt kleine Datenhäppchen über USB zugeworfen, verarbeitet sie blitzschnell und gibt sie zurück. Selbst eine hypothetische Lösung, die fehlende Gewichte laufend vom Gastgeber nachlädt, würde an Bandbreite und Verzögerung scheitern. In der Praxis kommt sie gar nicht so weit.
Zwei unangenehme Nachrichten für Neueinsteiger
Das offizielle Software-Repository der Edge TPU wurde im April 2026 archiviert und ist seitdem schreibgeschützt. Das ist ein starkes Warnsignal für Neueinsteiger, auch wenn daraus allein noch keine formelle Abkündigung der Hardware folgt.
Gleichzeitig ist der Preis von ursprünglich rund 75 Dollar auf etwa 150 gestiegen, bei zeitweise schlechter Verfügbarkeit.
Wer bereits einen hat, kann ihn weiter nutzen; er wird nicht schlechter. Wer heute neu anfängt, sollte zu einem Hailo-8 oder einem der neueren Module greifen.
Der Generationensprung, der alles erklärt
Womit wir beim lehrreichsten Vorgang dieses ganzen Felds wären.
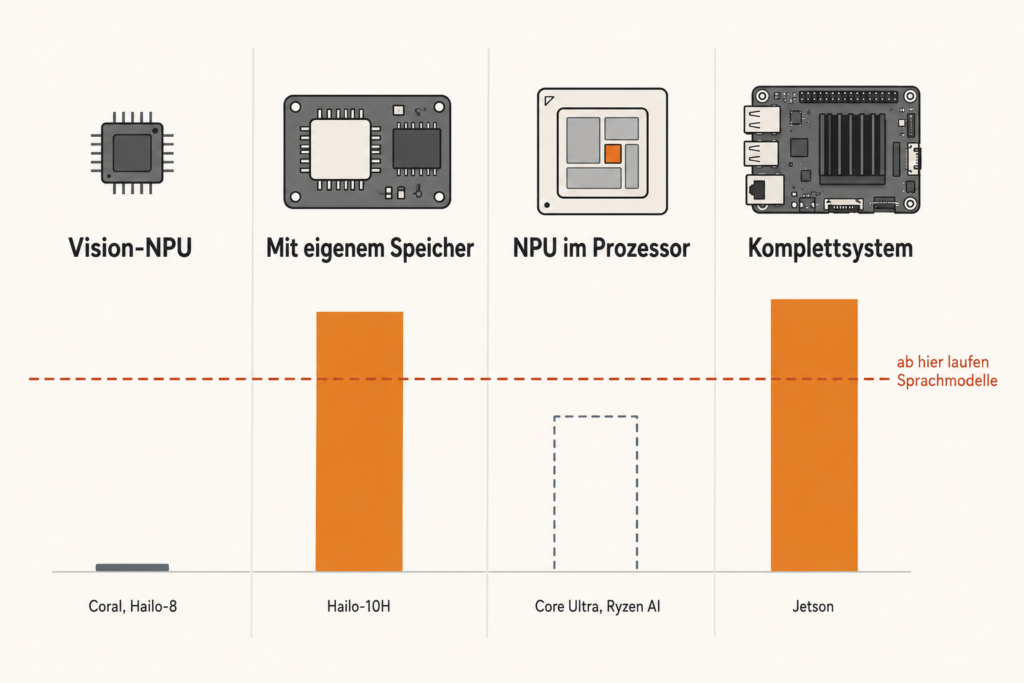
Raspberry Pi bietet für seinen Pi 5 eine Erweiterungsplatine an, den AI HAT+, mit einem Hailo-NPU. Zwei Stärken: 13 Billionen Operationen pro Sekunde für 70 Dollar, 26 Billionen für 110 Dollar.
Auch dieser Beschleuniger kann keine Sprachmodelle. Raspberry Pi schreibt das selbst mit bemerkenswerter Offenheit: Der AI HAT+ liefere erstklassige Beschleunigung für Bildmodelle, aber es fehle ihm die Fähigkeit, generative Modelle auszuführen.
Im Januar 2026 kam der Nachfolger, der AI HAT+ 2, zum offiziellen Preis von 130 US-Dollar. Und jetzt kommt die Zahl, auf die es ankommt.
Der neue Chip, ein Hailo-10H, leistet 40 Billionen Operationen pro Sekunde. Bei Bildmodellen ist er damit, und das ist kein Tippfehler, ungefähr gleich schnell wie sein 26-TOPS-Vorgänger.
Der Unterschied liegt woanders: Der AI HAT+ 2 hat 8 Gigabyte eigenen Arbeitsspeicher auf der Platine. Der Vorgänger besaß keinen großen dedizierten Speicher für Modellgewichte und Kontext und musste sich beim Pi bedienen.
Und plötzlich laufen Sprachmodelle.
Genau genommen war der Speicher die fehlende Voraussetzung, aber nicht die einzige Neuerung. Der Hailo-10H ist keine alte Architektur mit angeflanschtem RAM, sondern eine neue Chipgeneration mit zusätzlichen Rechenformaten und erweiterter Software. Raspberry Pi nennt beides als Grundlage: die neue Architektur und die 8 Gigabyte. Bemerkenswert bleibt trotzdem, wo der Fortschritt gerade nicht stattfand, nämlich bei der beworbenen Rechenleistung.
TOPS allein reichen nicht. Ohne passenden Speicher und Softwareunterbau läuft kein Sprachmodell.
Wie ernst das gemeint ist, zeigt ein Detail aus einem unabhängigen Test: Der Rezensent betrieb den AI HAT+ 2 an einem Raspberry Pi mit gerade einmal zwei Gigabyte Arbeitsspeicher. Das Modell wohnt eben auf der Zusatzplatine, nicht im System.
Der Blick auf Axelera zeigt zugleich, wie schnell sich dieser Markt bewegt. Metis ist mit 214 TOPS vor allem als Vision-Beschleuniger positioniert; inzwischen demonstriert der Hersteller auf der Plattform allerdings auch ein kleines Llama-3.2-Modell. Eine hohe TOPS-Zahl garantiert also weder Sprachmodell-Unterstützung noch deren Fehlen. Entscheidend sind Speicherarchitektur, unterstützte Rechenoperationen, Übersetzungswerkzeug, Laufzeitumgebung und verfügbare Modelle. Wer heute kauft, sollte diese fünf Punkte für das konkrete Gerät prüfen statt sich auf eine Kennzahl zu verlassen.
Der Chip einzeln: Hailo-10H als M.2-Modul
Denselben Baustein gibt es auch ohne Raspberry Pi drumherum, nämlich als M.2-Modul. Anbieter sind unter anderem AAEON, Geniatech und UP Bridge the Gap. Das offizielle Produktblatt nennt Ausführungen mit 4 oder 8 Gigabyte eigenem Speicher; einzelne Anbieter bewerben größere Ausbaustufen, was vor einem Kauf am konkreten Datenblatt zu prüfen ist.
Die Daten sind für ein Bauteil dieser Größe erstaunlich: 40 Billionen Operationen pro Sekunde bei 2,5 Watt typischer Leistungsaufnahme, angebunden über PCIe der dritten Generation mit vier Leitungen. Ein Test maß rund 9,45 Token pro Sekunde mit einem Modell von 1,5 Milliarden Parametern.
Elegant ist die Arbeitsteilung: Der Chip übernimmt die komplette Kette, also die Zerlegung des Textes in Token, die eigentliche Berechnung, die Rückübersetzung und die Verwaltung des Zwischenspeichers, und lässt den Hauptprozessor völlig in Ruhe. Es gibt sogar eine Anbindung an Ollama, eines der gängigen Programme zum Betrieb lokaler Modelle. Das bedeutet allerdings nicht, dass beliebige Modelle aus der normalen Ollama-Bibliothek unverändert laufen. Unterstützt wird nur, was für den Hailo-Unterbau bereits vorliegt oder entsprechend übersetzt wurde.
Ein Detail am Rande, das die Zielgruppe verrät: Der Hersteller gibt für das Modul einen industriellen Betriebstemperaturbereich von -40 bis 85 °C an. Diese Bausteine sind in erster Linie für Fahrzeuge, Kameras und Industrieanlagen gedacht. Heimanwender sind ein Nebenprodukt.
Die Anschlussfrage, die viele Pläne zerstört
Hier scheitern die meisten Ideen, und zwar früh.
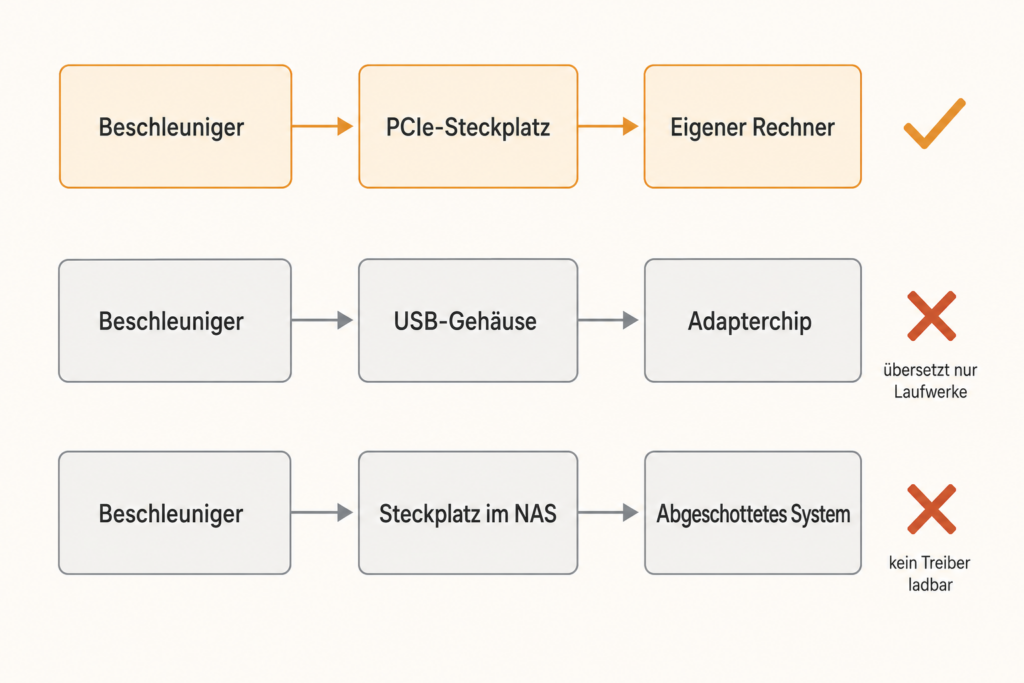
Die hier behandelten Hailo-Varianten für generative Modelle werden über PCIe angebunden, den internen Steckplatzstandard von Rechnern. Eine offiziell unterstützte USB-Ausführung gibt es dafür derzeit nicht. Das ist keine Naturgesetzlichkeit, externe Grafikkartengehäuse über Thunderbolt etwa führen echtes PCIe nach außen, aber für diese Modulklasse gilt es.
Wer hofft, ein M.2-Modul in ein USB-Gehäuse zu stecken und an ein fertiges Gerät zu hängen, etwa an ein Netzwerklaufwerk, wird enttäuscht. Solche Gehäuse enthalten einen Brückenchip, der ausschließlich Speicherlaufwerke übersetzt. Ein Beschleuniger ist kein Speicherlaufwerk.
Bei fertigen Geräten kommt ein zweites Hindernis dazu, das schwerer wiegt als das erste: Deren Betriebssysteme sind abgeschottet. Ein Beschleuniger braucht einen Treiber tief im System, und genau das lassen solche Geräte in der Regel nicht zu. Der Coral funktioniert auf manchen Fertigsystemen dennoch, weil für ihn fertige Pakete und Integrationen existieren und ein USB-Gerät leichter nachrüstbar ist als eine interne Steckkarte. Ohne Software geht es aber auch bei ihm nicht: Er benötigt die zugehörige Laufzeitumgebung und passende Treiberunterstützung.
Die praktische Konsequenz: Beschleuniger gehören in einen Rechner, den man selbst kontrolliert, oder in ein Gerät, das ab Werk dafür gebaut ist. Es gibt inzwischen fertige Industrie-Boxen, die einen M.2-Platz mitbringen und wahlweise Module von Hailo, MemryX, NXP oder DEEPX aufnehmen. Für den Heimgebrauch ist der Raspberry Pi der bequemste Weg.
Die Grenzen, die man vorher kennen sollte
Erstens: die Speicherdecke. Acht Gigabyte reichen je nach Architektur und Quantisierung typischerweise für kleine Modelle im Bereich von etwa einer bis sieben Milliarden Parametern. Am oberen Ende bleibt allerdings wenig Reserve für Kontext und Arbeitsdaten. Für einfache Klassifikation, begrenzte Assistenzaufgaben und kurze Zusammenfassungen kann das genügen; für anspruchsvolle deutsche Fachtexte meist nicht.
Zweitens: der Formatzwang. Modelle müssen durch den hauseigenen Übersetzer des Herstellers und in dessen Format gebracht werden. Man ist auf den gepflegten Katalog angewiesen. Ein normaler Mini-PC mit verbreiteter Laufzeitumgebung unterstützt dagegen eine wesentlich größere Auswahl frei verfügbarer Modelle und ist nicht an einen einzelnen Herstellerkatalog gebunden. Ganz beliebig ist auch das nicht, Architektur, Betriebssystem und Speicher setzen ebenfalls Grenzen. Aber der Unterschied ist erheblich, und bei der Geschwindigkeit dieses Felds ist er ein realer Preis.
Drittens: kein USB für die interessanten Varianten. Siehe oben.
Viertens: Deutsch. Bei Modellen dieser Größe ist die Qualität deutschsprachiger Ausgaben deutlich schwächer als bei englischen. Für deutsche Fachtexte ist das die Klasse, in der es unbefriedigend wird.
Fünftens: die Abwärme. Sparsam heißt nicht kühl. Ein Maker, der einen tragbaren Sprachassistenten auf einem Raspberry Pi baute, berichtet, dass seine Beschleunigerkarte erheblich Abwärme erzeugt. Er musste mit mehreren Aufbauvarianten experimentieren und die Karte schließlich auf einen separaten Adapter setzen, um genug Luftstrom zu bekommen.
Wer ein solches Modul in ein enges Gehäuse baut und rund um die Uhr laufen lässt, sollte die Kühlung von Anfang an mitplanen. Das relativiert das Bild vom Gerät, das man einschaltet und vergisst, zumindest beim Aufbau. Im Betrieb stimmt es dann wieder.
Dazu kommt eine sechste Einschränkung, die nichts mit Technik zu tun hat: Diese Produkte sind für Firmen gemacht. Sie werden über Distributoren an Gerätehersteller verkauft, kommen ohne Endkundensupport, und der Preis für ein einzelnes Stück ist selten attraktiv. Als Privatperson bewegt man sich hier am Rand einer Industrie, die einen nicht als Kunden im Blick hat.
Wofür sie wirklich gut sind
Nach so viel Dämpfung die andere Seite. Ellen ist eine illustrative Figur, aber ihr Szenario ist alles andere als konstruiert: Die Kombination aus Überwachungssoftware und Beschleuniger ist der mit Abstand verbreitetste Einstieg in dieses Thema.
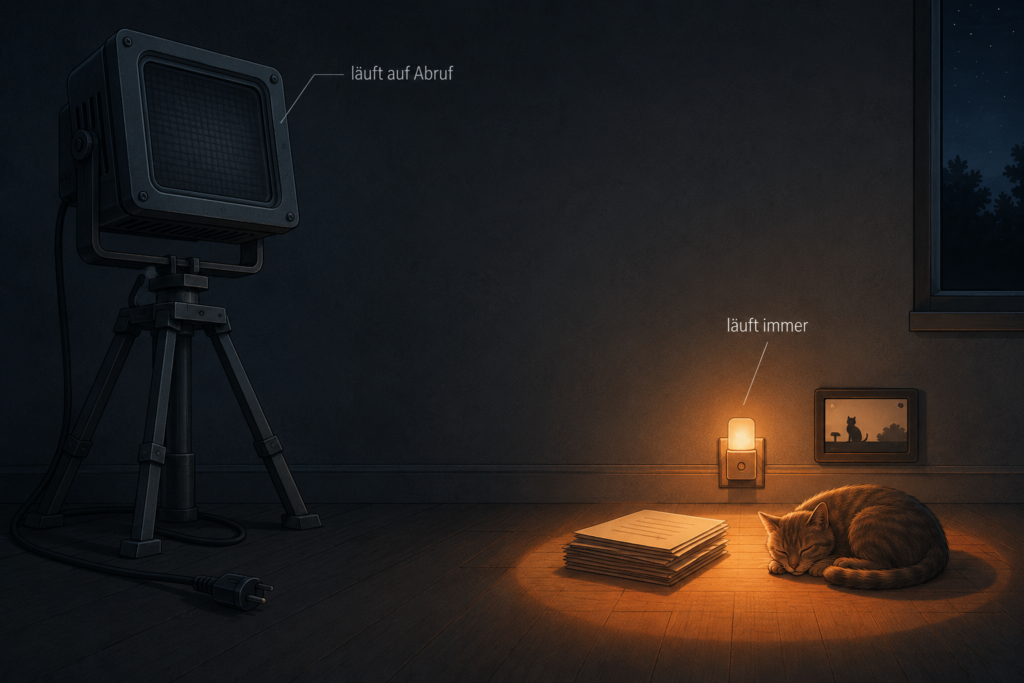
Die Stärke dieser Geräte heißt Dauerbetrieb. Und dazu gehört ein Faktor, den Ellen am Anfang dieses Textes als Erstes bemerkt hat: das Geräusch.
Große Rechner mit mehreren Grafikkarten sind unter Last laut. Ein c’t-Test maß bei einem solchen System 0,6 Sone im Leerlauf, 2,5 Sone bei Teillast und 6,8 Sone unter Volllast, verbunden mit der Empfehlung, es möglichst in einem separaten Raum aufzustellen. Ein passiv gekühltes Beschleunigermodul an einer kleinen Platine ist dagegen vollständig lautlos.
Für ein Gerät, das nachts im Wohnzimmer Kameras auswertet, entscheidet das oft mehr als jede Tokenrate. Ellens Problem war nie zu wenig Rechenleistung. Es war der Lüfter.
Daraus ergeben sich Anwendungsfälle, für die eine große Grafikkarte die vollkommen falsche Antwort wäre:
| Anwendung | Passendes Gerät | Warum es hier Sinn ergibt |
|---|---|---|
| Überwachungskameras. Person, Auto, Paketbote erkennen, statt bei jedem Ast zu alarmieren | Coral, Hailo-8, DEEPX | Läuft rund um die Uhr. Der klassische Einstiegsfall |
| Mehrere Kameras parallel | Hailo-8 | Auf stabilen Durchsatz bei mehreren Strömen ausgelegt |
| Sprachassistent im Haus. Befehle verstehen, ohne dass etwas nach draußen geht | AI HAT+ 2 | Für begrenzte Befehlssätze reichen kleine Modelle oder klassische Absichtserkennung. Offene Gespräche und zuverlässiges Deutsch verlangen deutlich mehr |
| Weckwort- und Audioerkennung. Dauerhaft zuhören, bis ein Stichwort fällt | Prozessor, Mikrocontroller oder unterstützte NPU | Sehr kleine Daueraufgabe. Eine NPU lohnt erst, wenn ein passendes Modell vorliegt und weitere Aufgaben parallel laufen |
| Dokumente vorsortieren. Rechnung, Vertrag, Werbung? | AI HAT+ 2 | Klassifikation ist eine einfache Aufgabe für ein kleines Modell |
| Suchindizes berechnen für ein eigenes Dokumentensystem | AI HAT+ 2, Hailo-10H | Läuft im Hintergrund, oft über Stunden. Setzt voraus, dass ein passendes Einbettungs- oder Klassifikationsmodell im unterstützten Katalog vorliegt |
| Robotik und Prozesssteuerung. Bildauswertung an der Maschine | Hailo-8, DEEPX, Axelera | Kein Netzwerk, keine Latenz, industrietaugliche Temperaturbereiche |
| Bastelprojekte mit eigenen Modellen | MemryX MX3 | Offene Treiber, offenes SDK, gute Dokumentation |
Wie ein Sprachassistent konkret aussieht
Weil „Sprachassistent im Haus“ in der Tabelle abstrakt bleibt, hier ein dokumentierter Aufbau. Ein Maker aus Hongkong baute einen tragbaren Assistenten auf einem Raspberry Pi 5 mit Beschleunigerkarte, kleinem Farbdisplay und Akku, später ergänzt um eine Kamera für Bilderkennung.
Die Software besteht aus drei Bausteinen, die alle lokal laufen:
- Whisper wandelt gesprochene Sprache in Text
- Ollama führt das eigentliche Sprachmodell aus und formuliert die Antwort
- Piper spricht die Antwort wieder aus
Der Reiz dieses Aufbaus ist, dass er vollständig ohne Internet funktioniert. Kein Byte verlässt das Gerät, sofern man es nicht ausdrücklich will. Genau das ist der Fall, für den diese Geräteklasse gebaut ist, und er braucht keine 128 Gigabyte.
Die eigentlich interessante Idee: Arbeitsteilung
Der spannendste Einsatz steht in keiner Produktbeschreibung, weil er zwei Geräte betrifft.
Ein Beschleuniger muss nicht das Hauptmodell betreiben. Er kann die Nebenrollen übernehmen: eingehende Dateien vorsortieren, Kameras überwachen, auf ein Stichwort warten, und, sofern ein unterstütztes Einbettungsmodell verfügbar ist, auch Dokumente für die Suche aufbereiten. Das eigentliche Sprachmodell läuft dann auf einem stärkeren Gerät oder wird bei Bedarf über eine Schnittstelle zugeschaltet.
So arbeitet ein Gerät für zweieinhalb Watt rund um die Uhr, und das teure läuft nur dann, wenn es wirklich gebraucht wird. In einem Heimnetz mit Netzwerklaufwerk, Kameras und Hausautomatisierung ist das oft die sinnvollste Aufteilung überhaupt.
Das ist nicht die spektakuläre Antwort. Aber sie kostet weniger Strom als eine Nachttischlampe.
Was davon praktisch erreichbar ist
Nach dieser Rundreise die ehrliche Verdichtung. Für Privatpersonen bleiben drei Wege:
Der Raspberry Pi AI HAT+ 2 ist derzeit eines der wenigen leicht erhältlichen und klar dokumentierten Endkundenprodukte für kleine generative Modelle in dieser Leistungsklasse. Raspberry Pi bietet ihn offiziell für 130 US-Dollar an; dazu kommt der Raspberry Pi 5 selbst.
Ein Hailo-8 oder DEEPX im eigenen Mini-PC lohnt sich, wenn es um Kameras und Bildverarbeitung geht und man einen freien M.2-Platz hat. Deutlich günstiger als die LLM-fähigen Module.
Weitere M.2-Karten für Einplatinenrechner gibt es inzwischen auch von kleineren Anbietern, etwa die LLM-8850 von M5Stack mit 24 TOPS für 139 US-Dollar. Bei solchen Angeboten gilt allerdings die Regel dieses Artikels doppelt: Vor dem Kauf klären, wie viel eigenen Speicher die Karte mitbringt und welche Modelle im Katalog des Herstellers vorliegen. Eine TOPS-Zahl allein sagt darüber nichts.
Die NPU im vorhandenen Rechner kostet nichts, weil sie schon da ist. Erster Schritt vor jedem Kauf.
Und ein vierter Weg, der oft der bessere ist: gar keinen Beschleuniger kaufen, sondern das Geld in einen sparsamen Mini-PC stecken, der die Aufgabe ohne Spezialchip erledigt. Bei zwei Kameras und gelegentlicher Klassifikation ist das häufig die einfachere Lösung.
Die Rechnung, die man vorher aufmachen sollte
Wer mit dem Gedanken spielt, über den Beschleuniger an Sprachmodelle zu kommen, sollte kurz die Preise nebeneinanderlegen.
| Weg | Kosten (Stand August 2026) | Was dabei herauskommt |
|---|---|---|
| AI HAT+ 2 plus Raspberry Pi | rund 250 € | Modelle von etwa einer bis sieben Milliarden Parametern, 2,5 Watt, lautlos |
| Grafikkarte mit 16 GB, AMD | ab rund 420 € | 30 bis über 60 Token pro Sekunde bei deutlich größeren Modellen |
| Grafikkarte mit 16 GB, NVIDIA | ab rund 550 € | dasselbe, spürbar schneller |
Wichtige Einschränkung zu den Grafikkartenpreisen: Der Markt steht unter einer Speicherknappheit, und ausgerechnet die 16-Gigabyte-Klasse trifft sie am härtesten. Der verbaute Speicher machte zeitweise rund 260 Euro des Verkaufspreises aus, vor der Krise waren es etwa 50. In Asien verteuerten sich einzelne Modelle dieser Klasse zwischen Ende Juli und Anfang August 2026 um fast die Hälfte. Prüfe die aktuellen Preise, bevor du auf diese Tabelle baust.
Die Zahlen sagen dennoch etwas Unbequemes: Der Beschleuniger ist nicht der günstigere Weg zu Sprachmodellen. Für ungefähr das Doppelte bekommt man eine völlig andere Modellklasse.
Er ist der Weg zu einer anderen Betriebsart. Wer wirklich mit Sprachmodellen arbeiten will, sollte die 250 Euro nicht in einen Beschleuniger stecken. Wer dagegen etwas Kleines rund um die Uhr laufen lassen will, findet für dieses Geld nichts Besseres.
Wenn es doch ein großes Sprachmodell sein soll
Dieser Beitrag behandelt bewusst die kleine, sparsame Klasse. Wer ein vollwertiges Sprachmodell zu Hause betreiben will, findet die Einordnung dazu in Lokale KI: Welche Hardware Sie wirklich brauchen und welche nicht.
Dessen Kernaussage passt genau zum Generationensprung beim AI HAT+ 2: Nicht die Rechenleistung entscheidet, sondern ob das Modell vollständig in den schnellen Speicher passt. Wie hart diese Schwelle ist, zeigt eine Messung an ein und derselben Maschine. Solange das Modell in den Grafikspeicher passte, lieferte sie 152 Token pro Sekunde. Sobald es das nicht mehr tat, waren es 13.
Praktisch heißt das: Für Modelle in der Größenordnung von gpt-oss-120b oder für komfortabel betriebene quantisierte 70B-Modelle sind meist 80 bis 128 Gigabyte schneller zusammenhängender Speicher sinnvoll. Viele leistungsfähige Modelle der 14- bis 35-Milliarden-Klasse laufen dagegen bereits auf 16 bis 32 Gigabyte Grafikspeicher. Und vor jedem Kauf lohnt ein Test mit vorhandener Hardware, weil ein Wochenende Ausprobieren deutlich weniger kostet als ein Fehlkauf.
Fazit: die richtige Frage stellen
Ellens Server läuft heute wieder ruhig. Der Stick, der das bewirkt hat, wäre für ein Sprachmodell vollkommen nutzlos. Beides ist wahr, und beides gehört zusammen.
Wer nach Hardware für ein großes lokales Sprachmodell sucht, wird von dieser Produktgattung enttäuscht. Sie ist keine günstige Abkürzung, sondern etwas anderes.
Wer dagegen eine klar umrissene Aufgabe hat, die dauerhaft laufen soll, findet hier etwas, das keine Grafikkarte bieten kann: eine Lösung, die man einschaltet und danach vergisst.
Die Frage lautet also nicht „Wie viele Billionen Operationen bekomme ich für siebzig Euro?“. Sie lautet: „Soll dieses Gerät gelegentlich etwas Großes rechnen oder ständig etwas Kleines?“
Von der Antwort hängt alles ab. Und bemerkenswerterweise ist es dieselbe Frage, die auch über den Kauf einer 4.000-Euro-Maschine entscheidet. Nur die Antwort fällt dann anders aus.
FOUNDIC.org ist werbefrei und ohne Bezahlschranke. Wenn dir dieser Beitrag etwas gebracht hat:  Lade uns auf einen Kaffee ein