Was der Begriff wirklich meint, wie die Architektur funktioniert und warum „bauen oder kaufen“ die falsche Frage ist.
Ein typischer Fall: Miriam aus dem Einkauf fragt ihren neuen Firmenassistenten, welche Spesensätze für Dienstreisen nach Tschechien gelten. Die Antwort stimmt, samt Quellenangabe. Nur stammt sie nicht aus der Reisekostenrichtlinie, sondern aus einer Tabelle der Buchhaltung: der Auswertung aller abgerechneten Dienstreisen des Vorjahres, mit Namen, Zielorten und Einzelbeträgen. Auf diese Datei hätte Miriam keinen Zugriff haben dürfen.
Die Retrieval-Schicht hatte die inhaltlich relevanteste Quelle gefunden, genau dafür ist sie gebaut. Das Sprachmodell hatte sie korrekt verarbeitet. Der Fehler lag eine Ebene tiefer: Relevanz war geprüft worden, Berechtigung nicht.
Um diese Schicht geht es hier.
Das Wichtigste vorab
- Ein Unternehmens-GPT ist kein Sprachmodell und keine einzelne Software, sondern eine Schicht aus sieben Bausteinen zwischen Mitarbeitenden und Systemen.
- „GPT“ ist eine Bauart von Sprachmodellen, keine Produktkategorie. Nennt ein Anbieter sein Produkt „Company GPT“, ist damit noch nichts über den Funktionsumfang gesagt.
- Ein Custom GPT und ein Unternehmens-GPT liegen auf unterschiedlichen Ebenen, sie sind keine Alternativen.
- Die sechs hier betrachteten Anbieter konvergieren im Funktionsumfang, nicht in der Architektur.
- Für wissensbasierte Assistenten entscheidet die Retrieval-Bauweise mehr als die Modellwahl.
- „Bauen oder kaufen“ ist falsch gestellt. 78,3 Prozent der von BCG Befragten fahren hybrid.
- Der Preis je Token fällt, der Preis je erledigter Aufgabe nicht zwangsläufig.
- Von zehn dokumentierten Praxisfällen hat genau einer eine externe Wirkungsmessung.
Der Artikel folgt drei Fragen: Was ist das? Wie baut man es richtig? Und muss man es selbst bauen? Er baut auf unserem Vergleich der KI-Bausteine von OpenAI, Anthropic, Google und Microsoft auf.
I. Was ein Unternehmens-GPT ist
Ein Unternehmens-GPT ist eine zentral bereitgestellte und vom Unternehmen governte KI-Arbeitsumgebung. Über sie erreichen Mitarbeitende allgemeine KI-Fähigkeiten, internes Unternehmenswissen und, je nach Ausbaustufe, Unternehmenssysteme, Werkzeuge und Agenten. Bestehende Identitäten und Berechtigungen werden berücksichtigt. Das Sprachmodell darunter kann, muss aber nicht von OpenAI stammen.
„Governt“ statt „kontrolliert“ ist Absicht. Ein Unternehmens-GPT als SaaS steht nicht unter technischer Kontrolle des Unternehmens, wohl aber unter dessen Steuerung bei Nutzern, Datenquellen, Richtlinien und Freigaben.
Ein selbst trainiertes Modell oder ein einfacher Dokumenten-Chatbot ist für sich genommen noch keine solche Plattform. Im Markt wird der Begriff „Company GPT“ allerdings auch für diese einfacheren Ausbaustufen verwendet, siehe die Tabelle weiter unten. Ebenfalls kein Ausschlusskriterium: Ein Unternehmens-GPT muss weder selbst entwickelt noch im eigenen Rechenzentrum betrieben werden.
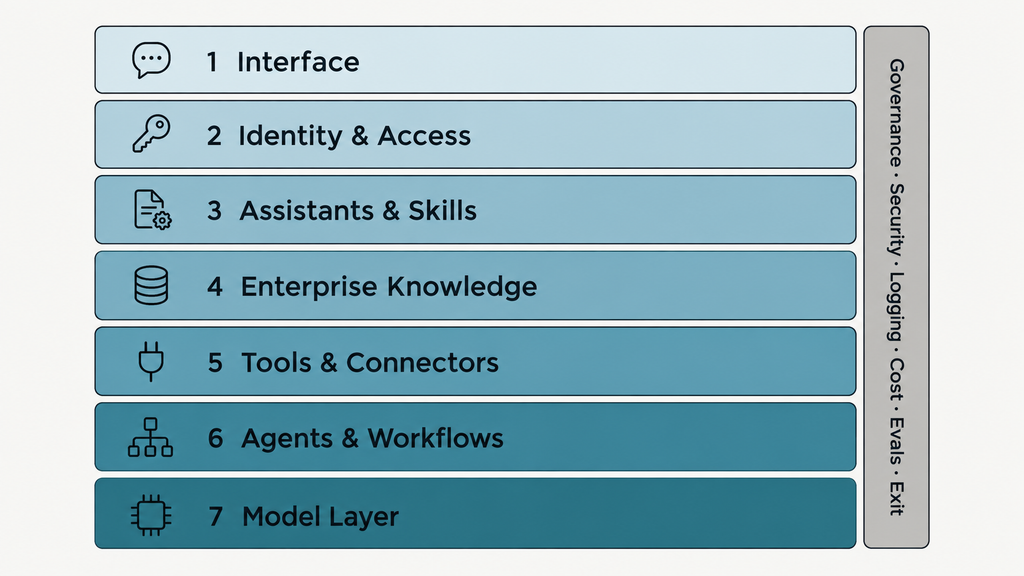
Es ist keine Software, sondern ein Stack aus sieben Schichten
| Schicht | Inhalt | Typische Frage |
|---|---|---|
| 1 Oberfläche | Chat, Teams, Browser, Mobil, Office | Wo begegnet es den Leuten? |
| 2 Identität und Zugriff | SSO, SCIM, RBAC, Nutzer- und Agentenidentität | Wer ist das, und was darf die Person sehen? |
| 3 Assistenten und Skills | Rollen, Instruktionen, Prozesswissen | Wie arbeitet unser Unternehmen? |
| 4 Unternehmenswissen | Retrieval, Index oder Live-Abruf, Lebenszyklus | Was weiß unser Unternehmen? |
| 5 Werkzeuge und Anbindungen | MCP, APIs, ERP, CRM, M365 | Was kann es abfragen und auslösen? |
| 6 Agenten und Abläufe | Planung, Aktionen, Freigaben | Was darf es selbst tun? |
| 7 Modellschicht | GPT, Claude, Gemini, Mistral, lokal | Welches Modell rechnet? |
Quer darunter liegen Governance, Sicherheit, Protokollierung, Kosten, Qualitätsmessung und Ausstiegsfähigkeit.
Kurz erklärt: Eine API ist eine Programmschnittstelle. Ein Token ist die Abrechnungseinheit der Anbieter, grob ein Wort oder eine Silbe. RAG (Retrieval-Augmented Generation) bedeutet, passende Quellenausschnitte zu suchen und dem Modell mitzugeben, damit es seine Antwort auf diese Quellen stützen kann. MCP (Model Context Protocol) ist der offene Standard für die Anbindung von Werkzeugen und Datenquellen, von Anthropic entwickelt und im Dezember 2025 an die Linux Foundation übergeben, mit AWS, Google, Microsoft und OpenAI als Platinum-Mitgliedern. Skills sind wiederverwendbare Arbeitsanweisungen oder Fähigkeitspakete; Anthropic beschreibt sie dateibasiert über Markdown, andere Anbieter lösen das anders.
In einfachen Architekturentwürfen stehen meist Oberfläche, Wissen, Anbindungen und Modell im Vordergrund, also die Schichten 1, 4, 5 und 7. Leicht unterschätzt werden Identität, wiederverwendbare Arbeitslogik und die Governance von Agenten. Genau dort liegt 2026 die Entwicklung, und genau dort entstehen Probleme, die sich später schwer nachrüsten lassen.
Fünf Ausbaustufen
| Stufe | Fähigkeit | Schwerpunkt |
|---|---|---|
| 1 Secure AI | allgemeine Aufgaben sicher erledigen | Enterprise Chat |
| 2 Know | das Unternehmen kennen | Retrieval, Enterprise Search |
| 3 Connect | lebende Systeme abfragen | Connectors, MCP, APIs |
| 4 Act | Aktionen in Systemen ausführen | Tools, Function Calling |
| 5 Work | mehrstufig arbeiten und korrigieren | Agents, Workflows, Skills |
Mit jeder Stufe steigen Integrations-, Sicherheits- und Governance-Aufwand deutlich. Wie so ein Aufstieg real verläuft, zeigt der Fall Hostinger weiter unten.
Warum der Begriff trotzdem verwirrt
GPT steht für Generative Pre-trained Transformer und bezeichnet eine Bauart von Sprachmodellen. Das ist kein eindeutig abgegrenzter Produktbegriff. Sowohl das US-Markenamt als auch das europäische Markenamt haben die Bezeichnung als beschreibend eingeordnet, die Verfahren sind teilweise nicht endgültig abgeschlossen. Für Einkäufer folgt daraus etwas Praktischeres als die Rechtslage: „Company GPT“ sagt zunächst fast nichts über das Produkt aus.
Fünf Bedeutungen, ein Wort
| Ausprägung | Was tatsächlich gemeint ist | Belegtes Beispiel |
|---|---|---|
| Einfach | sicheres internes ChatGPT | ONTEC, Wien: „your private GPT, like ChatGPT, but your data stays inside your organization“ |
| Knowledge | Chat plus Unternehmensdokumente | zahlreiche Kleinanbieter |
| Plattform | mehrere Modelle, Rechte, Anbindungen | codecentric c4 GenAI Suite, Apache 2.0 |
| Fortgeschritten | zusätzlich Tools und Unternehmenssysteme | Langdock, Berlin |
| Agentisch | zusätzlich Agenten, Workflows, Aktionen | CompanyGPT von innFactory, Rosenheim |
Custom GPT und Plattform liegen auf verschiedenen Ebenen
Ein Custom GPT ist eine Konfigurationsschicht innerhalb von ChatGPT. Er bleibt auf der Plattform: OpenAI betreibt Infrastruktur und Modellschicht, der Ersteller konfiguriert Instruktionen, Wissensdateien und gegebenenfalls Tools und Actions. Ein Unternehmens-GPT bezeichnet dagegen die Plattform selbst. Der eine kann Bestandteil des anderen sein.
Wer die Plattform selbst betreibt, setzt sie typischerweise aus fünf Komponenten zusammen: Oberfläche (Chainlit, Streamlit, LibreChat, Open WebUI), Backend mit Anwendungslogik und Authentifizierung, Datenbank für Konfiguration, Verläufe und Vektorsuche (MongoDB, Qdrant, Weaviate), eine Vermittlungsschicht zu den Modellen (LiteLLM, Portkey) und das Sprachmodell selbst.
Lizenzhinweise, die bei der Bausteinwahl zählen: Open WebUI ist seit Version 0.6.6 nicht mehr reines BSD-3, das Branding darf ab 50 Nutzern nicht mehr entfernt werden. LibreChat steht unter MIT und ist damit die unkomplizierteste Whitelabel-Option. Dify verbietet Mehrmandantenbetrieb auf Basis des Quellcodes. Flowise wurde im Sommer 2026 eingestellt.
Die Unterschiede zwischen Assistenten, Skills, Tools, Connectors und Agenten haben wir im Anbietervergleich aufgeschlüsselt.
Ausgangslage in Zahlen
Bitkom, 604 Unternehmen ab 20 Beschäftigten, Feldzeit KW 27 bis 32/2025:
| Kennzahl | Wert |
|---|---|
| Unternehmen, die KI einsetzen | 36 Prozent (2024: 20 Prozent) |
| mit direktem GenAI-Zugang für Beschäftigte | 26 Prozent, weitere 17 Prozent planen es |
| mit Regeln für KI-Nutzung | 23 Prozent (Vorjahr 15 Prozent) |
| die private KI-Nutzung vermuten | 4 von 10 |
| Schatten-KI „weit verbreitet“ | 8 Prozent (2024: 4 Prozent) |
Beschäftigtenseite, Bitkom vom 5. Mai 2025, n=1.005: 45 Prozent nutzen generative KI im Job mit Wissen des Arbeitgebers, 10 Prozent ohne. Das ist der eigentliche Auslöser der meisten Projekte. Nicht eine Innovationsstrategie, sondern die Beobachtung, dass die Belegschaft längst angefangen hat.
Der Nutzen, um den es dabei geht, ist gut beziffert. Atlassian hat für den „State of Teams 2025″ 12.000 Wissensarbeiter in sechs Ländern und 200 Führungskräfte aus Fortune-1000-Unternehmen befragt. Befund wörtlich: „leaders and teams waste 25% of their time just searching for answers“. Ein Viertel der Arbeitszeit geht für die Suche nach Informationen drauf, die im Unternehmen längst vorhanden sind.
Was die Anbieter liefern
| Anbieter | Vereinfacht gesagt | Produktnamen und Besonderheit |
|---|---|---|
| OpenAI | ChatGPT plus Firmenwissen plus Apps | Company Knowledge; Apps können schreiben: „moving beyond read/search … including write/modify actions“ |
| Microsoft | Copilot plus Arbeitskontext plus Agenten | M365 Copilot, Work IQ, Copilot Studio, Entra Agent ID, Agent 365. Work IQ ist „a workplace intelligence layer that enables agents to access and reason over organizational data, context, and tools“, in Copilot Studio ausdrücklich Preview |
| Anthropic | Claude plus Unternehmenssuche plus MCP | „Ask Your Org“. Kein zentraler Index: „Search results are generated by making MCP calls. No data from connected services are indexed in our systems for serving queries“ |
| Gemini plus Connectors plus Agenten | Gemini Enterprise, Agent Platform, A2A-Einbindung | |
| AWS | zentraler Arbeitsassistent plus Automatisierung | Amazon Q Business „is no longer open to new customers“, Nachfolger Amazon Quick |
| Mistral | modell- und betriebsflexibler Unternehmensassistent | seit 28. Mai 2026 Vibe, vormals Le Chat. Serverless, dedizierte VPC oder self-hosted |
Die Stacks konvergieren im Kernfunktionsumfang. Die Architekturen dahinter nicht: zentraler Index gegen Live-Abruf, Suite-gebunden gegen modellagnostisch, Platzpreis gegen Verbrauchsabrechnung.
II. Wie die Schicht gebaut wird
Typ 0: wann gar kein Retrieval gebraucht wird
Bevor es um Bauweisen geht, die Frage davor. Moderne Modelle haben Kontextfenster von bis zu einer Million Token. Bei einer kleinen, klar abgegrenzten Dokumentenmenge, einem einzelnen Vertrag etwa oder einer einmaligen Datenextraktion, kann direkte Verarbeitung im Kontextfenster einfacher und oft auch genauer sein als eine zusätzliche Retrieval-Pipeline.
Anthropic hält es im eigenen Produkt so. Aus der Hilfeseite zu Projects, Stand 11. September 2026: „When possible, projects will use in-context processing for optimal performance“ und „RAG automatically activates when your project approaches or exceeds the context window limits“. Fällt der Projektinhalt später wieder unter die Schwelle, wird zurückgeschaltet.
Faustregel: Erst wenn das Material wächst, dieselbe Art Frage wiederkehrt oder sich das Wissen laufend ändert, gewinnt Retrieval deutlich an Wert. Ein großes Kontextfenster heißt allerdings nicht, dass Modelle darin zuverlässig alles finden. Dateiformat, Toollimits, Latenz und Modellwahl spielen ebenfalls hinein.
Die Architekturentscheidung: drei Retrieval-Bauweisen
Für wissensbasierte Unternehmensassistenten ist die Retrieval-Bauweise oft wichtiger als die Wahl zwischen GPT, Claude oder Gemini.
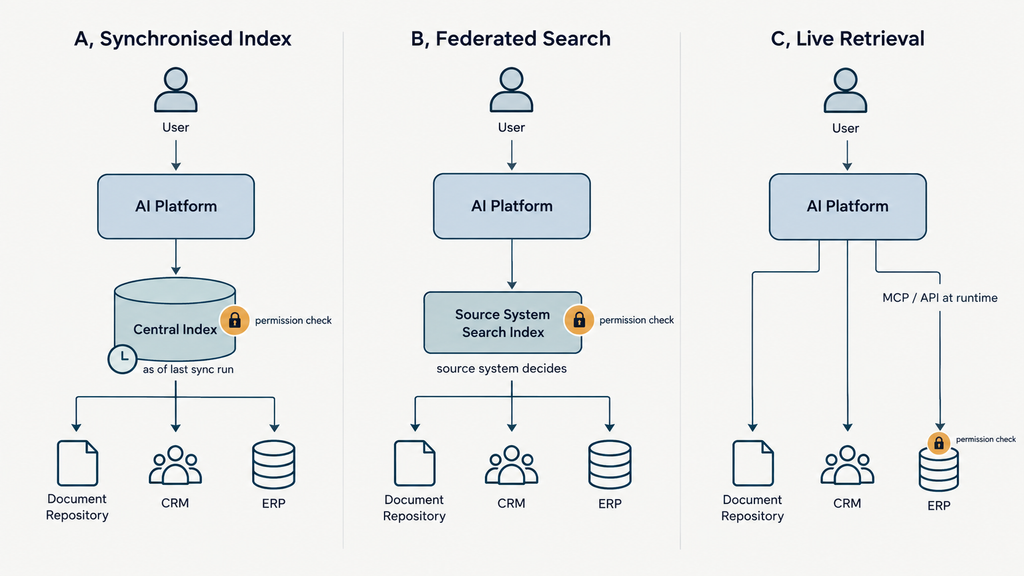
| Typ | Funktionsweise | Berechtigungen | Aktualität |
|---|---|---|---|
| A, synchronisierter Index | Dokumente werden zerlegt, eingebettet, zentral indexiert | Zugriffsrechte müssen als Metadaten mitgeführt und gepflegt werden | Stand des letzten Indexlaufs |
| B, föderierte Suche | Abfrage an den Suchindex des Quellsystems | Quellsystem entscheidet | Aktualität des Quellsystems |
| C, Live-Abruf | kein Index, Abruf zur Laufzeit über Werkzeuge oder MCP | Nutzer authentifiziert sich am Quellsystem | keine zusätzliche Indexverzögerung |
Belege: AWS zu Typ A, „connectors index access control list (ACL) information that’s attached to a document along with the document itself“. Microsoft zu Typ B mit synchronisierten und föderativen Mustern. Anthropic zu Typ C, ohne Index für die Beantwortung.
Quer dazu zwei Erweiterungen. Agentic Retrieval, seit August 2025 bei AWS dokumentiert: „Intelligently deconstructs complex queries into simpler ones“, mehrere Suchdurchgänge, Qualitätsprüfung. Und die strukturierte Abfrage, also Datenbankabfrage statt Dokumentensuche, wenn die Antwort in einer Tabelle steht.
Bei periodischer Indexierung bleiben Inhalte und Rechte bis zum nächsten Synchronisationslauf potenziell veraltet, bei einem nächtlichen Lauf also bis zu 24 Stunden. Typ C umgeht das, löst aber Aufbewahrungsfristen, Zwischenspeicher, Protokolldaten und die Qualität der Quelldaten nicht.
Warum Retrieval in der Praxis schlecht funktioniert
Die Bauweise entscheidet, wo die Rechteprüfung sitzt. Über die Trefferqualität entscheiden zwei andere Hebel, und beide werden in einfachen Eigenbauten häufig unterschätzt.
Hybrid Search. Die reine Bedeutungssuche ist stark bei Sinnzusammenhängen und schwach bei Eigennamen, Artikelnummern und Fachbegriffen. Deshalb läuft parallel eine klassische Stichwortsuche, technisch meist BM25, und beide Trefferlisten werden zu einer zusammengeführt. Sucht jemand nach einer Artikelnummer, landet der richtige Treffer semantisch schnell auf Platz drei und fällt damit aus der Antwort. Mit Hybrid Search steht er auf Platz eins.
Reranking. Danach bewertet ein separates Reranker-Modell jeden vorausgewählten Textabschnitt noch einmal gegen die Originalfrage und sortiert neu. Aus zwanzig groben Treffern werden drei präzise. Solche Modelle kauft man ein, man entwickelt sie nicht selbst.
Bei Fragen, die mehrere logische Schritte verbinden, etwa „welcher Mitarbeiter betreute 2023 den Kunden X, bei dem ein Vertrag mit Force-Majeure-Klausel zum Einsatz kam“, stößt reine Ähnlichkeitssuche schnell an Grenzen. Eine mögliche Antwort sind Knowledge Graphs, die Wissen als Netz aus Entitäten und Beziehungen speichern. Andere Wege sind Metadatenfilter, strukturierte Datenabfragen oder mehrere Retrieval-Schritte hintereinander. Knowledge Graphs sind mächtig und teuer im Unterhalt, für die meisten Anwendungsfälle also der zweite Schritt, nicht der erste.
Berechtigung vor Relevanz
Das ist der Punkt aus Miriams Fall, und zugleich ein Datenschutzthema, das die deutsche Datenschutzaufsicht ausdrücklich adressiert. Die Datenschutzkonferenz hat im Oktober 2025 eine Orientierungshilfe zu RAG veröffentlicht. Kernsatz: „Im Vergleich dazu kann im Sprachmodell (LLM) selber nicht gesteuert werden, auf welche Informationen bestimmte Nutzer Zugriff haben dürfen.“ Im Retrieval-Subsystem seien dagegen „bewährte technische und organisatorische Maßnahmen, wie z. B. die Mandantentrennung/funktionale Trennung und das Rechte- und Rollenkonzept“ anwendbar, und zwar zu prüfen „bereits im Rahmen der Konzeption“.
Alle großen Anbieter formulieren dasselbe Prinzip. AWS legt die Zugriffsrechte neben jedes indexierte Dokument, Microsoft und OpenAI verweisen auf die Rechte des Quellsystems, und Anthropic liefert nur „data you have permission to access in the original systems“.
Zwei dokumentierte Fallstricke:
- Microsoft Copilot Connectors lassen sich auf „Visible to everyone“ stellen, mit ausdrücklicher Oversharing-Warnung. Nachträgliche Rechteänderung wird derzeit nicht unterstützt.
- Microsoft hat für das Aufräumen zu weit gesetzter Freigaben einen eigenen Leitfaden, Zweck wörtlich „remediating oversharing“.
KI erfindet Oversharing nicht, sie macht es skalierbar sichtbar
Ein Unternehmens-GPT macht zunächst vor allem eines sichtbar: Berechtigungsprobleme, die längst vorhanden waren. Deshalb ist das Aufräumen der Freigaben Projektvoraussetzung und nicht Nacharbeit.
Es bleibt aber nicht dabei. Durch Indexe, Zwischenspeicher, Werkzeuge und Agenten kommen neue Risiken hinzu: veraltete Kopien von Zugriffsrechten, Informationen, die erst in der Kombination brisant werden, zu weit gefasste Tool-Berechtigungen und Prompt Injection über indexierte Inhalte.
Dokumentierter Vorfall: EchoLeak, CVE-2025-32711, offengelegt am 12. Juni 2025, CVSS 9.3, Zero-Click gegen Microsoft 365 Copilot. Eine präparierte E-Mail wurde indexiert, bei einer beliebigen späteren Nutzerfrage schleuste der Payload Kontextdaten nach außen. Im Juni-Patchday behoben.
Risikomodell: Simon Willison nennt die Kombination aus Zugriff auf private Daten, Kontakt mit fremdkontrollierten Inhalten und Fähigkeit zur Außenkommunikation die „lethal trifecta“. Sobald ein System diese drei Eigenschaften verbindet, ist es angreifbar. Mit den Stufen Connect und Act wird genau dieses Szenario zunehmend realistisch.
Wenn das System handelt
Solange es antwortet, ist das schlimmste Risiko eine falsche oder zu freizügige Antwort. Sobald es handelt, lautet die Frage: Was kann es anrichten? Die praktikable Antwort ist eine Autonomieleiter, auf der je Prozess festgelegt wird, wie weit das System gehen darf:
lesen → analysieren → Vorschlag → Aktion vorbereiten
      → menschliche Freigabe → ausführen → autonom
Eine Referenzumsetzung dokumentiert der Rosenheimer Anbieter innFactory für seine Microsoft-365-Anbindung. Jeder Werkzeugaufruf läuft mit der Identität des angemeldeten Nutzers, schreibende Aktionen sind bewusst zurückhaltend gestaltet, und wörtlich: „E-Mails werden ausschließlich als Entwürfe angelegt, der Versand bleibt immer eine bewusste Entscheidung des Nutzers.“
Damit verbunden ist ein Thema, das in Deutschland gern übersehen wird. Ein selbst betriebenes System protokolliert Nutzer-IDs, Prompts und Verläufe. Das Arbeitsgericht Hamburg verneinte am 16. Januar 2024 (24 BVGa 1/24) ein Mitbestimmungsrecht nach § 87 Abs. 1 Nr. 6 BetrVG, weil die Beschäftigten ChatGPT über private Accounts nutzten und der Arbeitgeber keinen Zugriff auf erhobene Daten hatte. Bei einem eigenen System entfällt genau diese Voraussetzung. Eine Entscheidung dazu liegt nicht vor, für die Projektplanung ist Mitbestimmung dennoch einzukalkulieren.
Sobald Agenten nachts allein laufen oder sich gegenseitig aufrufen, reicht die Nutzeridentität nicht mehr. Dann braucht es eigene Maschinenidentitäten, kurzlebige Zugangsdaten, minimale Rechte und eine nachvollziehbare Zurechnung. Microsoft bietet dafür seit Mai 2026 Entra Agent ID und die Steuerungsebene Agent 365 an, beim W3C und bei der IETF laufen seit Frühjahr 2026 Arbeiten an offenen Standards. Fertig ist davon nichts.
III. Muss man das selbst bauen?
Was die Erhebungen sagen
| Quelle | Befund |
|---|---|
| BCG und Kore.ai, April 2025 | Frage „Which best describes your organization’s AI strategy?“: Hybrid 78,3 Prozent, Build in-House 5,0 Prozent, Buy Third-Party 16,7 Prozent. Stichprobengröße nicht ausgewiesen |
| BCG, September 2025, 1.250 CxOs | „11% of firms rely primarily on in-house development, and just 4% depend on a single, end-to-end vendor“ |
| McKinsey, August 2026, n=1.719 | Gegenbefund: „Nearly a third of respondents (32 percent) report that their organizations have decided against purchasing at least one software product or feature because they were able to build the functionality in-house using agentic coding tools“ |
| Gartner, Juni 2025 | „Over 40% of agentic AI projects will be canceled by the end of 2027, due to escalating costs, unclear business value or inadequate risk controls“ |
Vorsicht mit der 95-Prozent-Zahl. Eine Untersuchung des MIT vom Juli 2025 wird überall mit „95 Prozent der KI-Projekte scheitern“ wiedergegeben. Gemessen wurde etwas anderes: In der Stichprobe erreichten extern entwickelte Lösungen etwa doppelt so häufig den Produktivbetrieb wie intern gebaute, rund 67 gegen 33 Prozent. Rund 80 Prozent der befragten Organisationen hatten nie einen maßgeschneiderten Piloten, zählen aber in die 95 Prozent hinein. Basis sind 52 Interviews und 153 Fragebögen, das Erfolgskriterium ist nicht definiert, es gab keine Begutachtung, und alle vier Autoren kommerzialisieren agentische Systeme.
Drei Achsen statt einer Alternative
Die Optionen liegen nicht auf einer Linie:
- Bezugsform: Buy, Compose, Build. Die Umsetzung kann No-Code, Low-Code oder klassisch programmiert erfolgen
- Betriebsmodell: geteiltes SaaS, dedizierte VPC, eigener Tenant, On-Premises oder souveräne Cloud
- Ausbaustufe: die fünf Stufen von oben
Die Umsetzungsmethode wird dabei gern mit der Bezugsform verwechselt. Low-Code-Plattformen wie n8n oder Make sind keine vierte Option neben Buy, Compose und Build, sondern ein Weg, Compose oder Build umzusetzen. Sie eignen sich besonders, um erste Abläufe schnell aus bestehenden APIs, Modellen und Datenquellen zusammenzusetzen, inklusive Retrieval-Pipeline. n8n lässt sich auch selbst betreiben, andere Angebote wie Make sind primär SaaS. Mit wachsender Prozesskomplexität steigen Wartungs- und Governance-Aufwand allerdings schnell an, und einen schlecht definierten Prozess macht auch Low-Code nicht besser.
Die Achsen sind frei kombinierbar. Mistral Vibe gibt es serverless, in dedizierter VPC und self-hosted. Das deutsche CompanyGPT ist gekaufte Software im eigenen Tenant des Kunden. Merck ist Compose in der Bezugsform und SaaS im Betrieb. Die Gleichsetzung „Eigenbau gleich souverän“ hält auf diesen Achsen nicht.
Zehn Praxisfälle, ein gemessener Nutzen
| Fall | Ansatz | Belegtes Ergebnis / Nutzung | Evidenz |
|---|---|---|---|
| Bayer myGenAssist, seit 09/2023 | Compose auf GPT-4 Turbo, von Bayer gehostet | JMIR-Studie 03/2025, 122 Fälle Pharmakovigilanz, 22,25 auf 16,97 Minuten je Fall, „23.3% (95% CI 13.8%-32.8%; P<.001)“. „more than 40k employee users“ | peer-reviewed |
| Otto Group ogGPT, seit 09/2023 | Build auf Azure OpenAI | „Über 10.000 aktive monatliche Nutzer*innen … mehr als 420.000 Nachrichten pro Monat“ (12/2025) | Betreiberangabe |
| Merck myGPT Suite | Compose, eigener Chatbot plus Langdock | Start 10.000, nach sechs Monaten über 25.000 Nutzer, „mehr als 3.000″ Agenten. Nicht für klinische, regulatorische oder GxP-Daten | Anbieter-Case-Study |
| Deutsche Telekom AskT, seit 2024 | Buy, Plattformpartner von Glean zu UnifyApps gewechselt | keine Nutzerzahlen veröffentlicht | Betreiberangabe |
| Cisco AI Assistant | Build, mit Agent- und MCP-Registry | über 100.000 Nutzer, über 45 Mio. Interaktionen, 73 Prozent berichten höhere Produktivität. CIO.com nennt abweichend 96.000 Nutzer und 72 Prozent | Betreiberangabe |
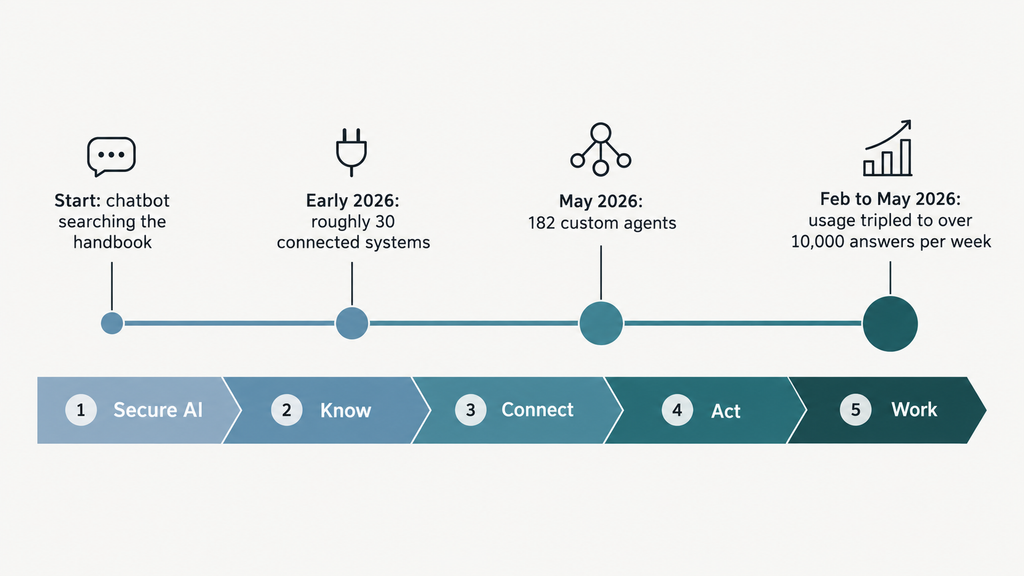
| Hostinger DEX | Build, Evolution über die Stufen | Start als Chatbot mit Handbuchsuche, Anfang 2026 „roughly 30 systems“, Mai 2026 „182 custom agents“, Nutzung Feb. bis Mai verdreifacht auf über 10.000 Antworten pro Woche | Betreiberangabe |
| Deloitte PairD, 01/2024 | Build auf GPT-3.5 | verfügbar für „Deloitte’s 5,900+ Belgian employees“ | Betreiberangabe |
| LLMoin, Hamburg und Dataport, seit Ende 2024 | Build, öffentliche Hand, modellagnostisch | „Mehr als 92.000 Nutzende“ in sieben Bundesländern | Betreiberangabe |
| F13 Baden-Württemberg | Build, öffentliche Hand, Open Source seit 07/2025 | Beta für rund 79.000 Lehrkräfte | Betreiberangabe |
| FEHRMANN Materials X, Hamburg und Lüneburg, Einheit seit 06/2023 | Build, aus dem internen Werkzeug wurde ein Produkt | matGPT und matOPT für Legierungsentwicklung und industrielles Wissen. Unternehmensangabe: „Entwicklungszyklen, die früher Monate dauerten, können jetzt auf nur noch Wochen oder sogar Tage reduziert werden“ | Betreiberangabe |
Zwei Anmerkungen. Für keinen der untersuchten Fälle ist ein selbst trainiertes Foundation Model dokumentiert, gebaut wird jeweils die Schicht darüber. Und F13 läuft nicht auf Aleph Alpha: Das Staatsministerium Baden-Württemberg schrieb am 23. Juli 2025, „nach dem Ausbau der Software zu einem Vollprodukt ist das Startup Aleph Alpha nicht mehr an der F13-Vollversion beteiligt“. Die Vollversion entwickelten InnoLab_bw und die PD.
Zwei Fälle sind besonders lehrreich. Hostinger macht die Stufen sichtbar: erst Handbuchsuche, dann Systemanbindung, dann selbstgebaute Agenten aus Technik, Marketing, QA, Produkt und Design.
FEHRMANN zeigt, dass die Rechnung nicht bei der Effizienz enden muss. Der Hamburger Aluminiumspezialist gründete im Juni 2023 eine eigene Einheit, um Legierungsentwicklung mit KI zu beschleunigen, machte daraus eine Kundenlösung und betreibt sie heute als eigene GmbH mit Enterprise-Plattform. Aus einem internen Werkzeug wurde ein Geschäftsfeld.
Der Fall ist nur eingeschränkt mit den übrigen vergleichbar: Er adressiert spezialisiertes Material- und Entwicklungswissen, keinen unternehmensweiten Mitarbeiterassistenten. Gerade deshalb zeigt er aber, wie aus einer internen KI-Schicht ein externes Produkt entstehen kann. Zwei Präzisierungen: Die kursierende Zahl „von fünf Jahren auf zwei bis vier Wochen“ steht in keiner auffindbaren Quelle, belegt sind nur unscharfe Varianten. Und matGPT ist heute das Wissenssystem, die Legierungsoptimierung heißt matOPT.
Was es kostet, in aller Kürze
Vier Preislogiken sind im Markt, und die Wahl zwischen ihnen entscheidet mehr als der Listenpreis:
- Platzpreis, fest pro Nutzer und Monat. Microsoft 365 Copilot, 30 US-Dollar jährlich gezahlt, zusätzlich zur bestehenden M365-Lizenz.
- Platzpreis plus Verbrauch. Claude Enterprise, 20 US-Dollar pro Platz, mindestens 20 Plätze, dazu die Nutzung zu API-Raten.
- Rein verbrauchsbasiert, nach Aktionen, Credits oder Token. Copilot Studio, 200 US-Dollar je 25.000 Credits, eine Agent-Aktion kostet fünf davon.
- Projekt plus Betrieb, ohne Nutzergebühr. CompanyGPT von innFactory, 14.990 Euro Setup, 399 Euro monatlich, Infrastruktur 500 bis 5.000 Euro.
Zwei Sätze, die man sich merken sollte. Der Preis je Token fällt seit Jahren dramatisch, der Preis je erledigter Aufgabe nicht: Das MIT zeigt im März 2026, dass die Betriebskosten der jeweils besten Modelle um Faktor 3 bis 18 pro Jahr steigen, weil Reasoning-Modelle für dieselbe Aufgabe viel mehr Token verbrauchen. Und McKinsey formuliert im Juli 2026 die Konsequenz: „The unit of governance should be the completed business outcome, not the token cost.“
Welche Preislogik passt, hängt am Nutzungstyp, und dieselbe Rechnung geht bei vier Typen gegensätzlich aus: Bei Gelegenheitsnutzern sind gebündelte oder verbrauchsbasierte Angebote attraktiv, bei intensiven menschlichen Nutzern kann ein fixer Platzpreis günstig sein, bei automatisierten Agenten dominiert der Verbrauch, weil die Zahl der Läufe zählt und nicht die Zahl der Köpfe, und bei konstanter Hochlast kann Eigenbetrieb rechnerisch interessant werden.
Qualität messen, in vier Ebenen
| Ebene | Frage | Metrik |
|---|---|---|
| Retrieval | Findet das System die richtigen Quellen? | Recall@k, Anteil Antworten ohne belastbare Quelle |
| Antwort | Ist die Antwort korrekt, vollständig, regelkonform? | Faktentreue gegen Goldstandard, Quellenbindung |
| Tool und Agent | Wählt es das richtige Werkzeug in der richtigen Reihenfolge? | Auswahlgenauigkeit, Schrittzahl, unerlaubte Aktionen |
| Geschäftsergebnis | Verändert sich die Arbeit messbar? | Durchlaufzeit, Nacharbeitsquote, Kosten je Vorgang |
Die vierte Ebene erklärt das auffälligste Zahlenpaar der jüngeren Forschung. McKinsey, August 2026: 80 Prozent der Befragten berichten höhere persönliche Produktivität, 37 Prozent einen positiven Beitrag zum Betriebsergebnis. Zugang zur KI kann die persönliche Produktivität erhöhen. Unternehmenswert entsteht erst, wenn sich der Prozess verbessert.
Die 70 Prozent, um die es in diesem Artikel nicht ging
Alles bisher Beschriebene ist Technik und Architektur. BCG hat untersucht, worauf erfolgreiche KI-Transformationen ihren Aufwand verteilen. Wörtlich, aus „From Potential to Profit“, Januar 2025: „They dedicate 10% of their efforts to algorithms; 20% to data and technology; and 70% to people, processes, and cultural transformation.“
Zehn Prozent Algorithmen, zwanzig Prozent Daten und Technologie, siebzig Prozent Menschen, Prozesse und kultureller Wandel. Die Aufteilung kursiert oft verdreht, deshalb die Originalzuordnung.
Das ist kein Fortschrittsbalken. Man kann daraus nicht ableiten, nach der technischen Arbeit seien dreißig Prozent des Projekts erledigt. Die Pointe ist eine andere: Selbst eine technisch hervorragende Plattform löst nur den kleineren Teil des Problems. Der größere Aufwand liegt bei Prozessen, Rollen, Schulung, Adoption und Veränderungsmanagement, und dieser Artikel behandelt ihn nicht.
Kompakt: AI Act. Der Digital Omnibus ist Verordnung (EU) 2026/1744 vom 8. Juli 2026, in Kraft seit 27. Juli 2026. Seit Februar 2025 gelten die Verbote nach Art. 5 und die KI-Kompetenz nach Art. 4, seit August 2025 die GPAI-Pflichten, seit August 2026 die Transparenzpflichten nach Art. 50. Die Hochrisiko-Pflichten nach Anhang III wurden auf Dezember 2027 verschoben, die nach Anhang I auf August 2028. Ein reiner interner Wissensassistent fällt typischerweise nicht in die Hochrisiko-Kategorien. Kommen HR-Anwendungen nach Anhang III Nr. 4 hinzu, greift eine Einzelfallprüfung nach Art. 6 Abs. 3: Das System gilt nicht als hochriskant, wenn es „does not pose a significant risk of harm to the health, safety or fundamental rights“, etwa bei enger Verfahrensaufgabe oder vorbereitender Tätigkeit. Rückausnahme: Es bleibt „always … high-risk where the AI system performs profiling of natural persons“. Art. 6 Abs. 4 verlangt eine dokumentierte Einschätzung.
Entscheidungsablauf
- Ist-Zustand messen. Wer nutzt heute was mit welchen Konten? Ohne diese Zahl planen Sie gegen ein Phantom.
- Anwendungsfälle mit Steckbrief bewerten. Benötigte Daten, Volatilität, Zielgruppe, messbarer Nutzen, technische Voraussetzungen. Für jeden wissensbasierten Fall sollte ein fachlich verantwortlicher Data Owner benannt sein.
- Berechtigungen aufräumen, vor der Technik. Projektvoraussetzung, nicht Nacharbeit.
- Ausbaustufe festlegen. Mit jeder Stufe steigen Integrations-, Sicherheits- und Governance-Aufwand deutlich.
- Retrieval-Bauweise wählen. Index, föderiert oder Live.
- Bezugsform und Betriebsmodell getrennt entscheiden. Die Preislogik dazu am Nutzungstyp prüfen, nicht am Listenpreis.
- Autonomiegrad je Prozess festlegen. Von lesen bis autonom, mit definierter Freigabestelle.
- Testset aufbauen, bevor ausgerollt wird. Vier Eval-Ebenen, versioniert, Vergleich gegen die Vorversion bei jeder Änderung.
Ausblick: eine gemeinsame Schicht unter vielen Oberflächen
Zwei Entwicklungen laufen parallel. Die eine ist die zentrale KI-Oberfläche vor allen Systemen: Glean, Amazon Quick, Anthropics Ask Your Org, LLMoin. Die andere ist eingebettete KI in den Fachanwendungen. Gartner erwartete im August 2025, dass bis 2026 bis zu 40 Prozent der Unternehmensanwendungen eingebaute aufgabenspezifische Agenten enthalten, gegenüber unter 5 Prozent damals.
Die Anbieter behandeln das nicht als Gegensatz. Microsoft baut beides: Copilot in den Anwendungen, Work IQ als gemeinsame Kontextschicht darunter, Agent 365 als Kontrollebene darüber. SAP bettet Joule ein und baut mit Joule Work zugleich eine eigene Oberfläche. Salesforce positioniert Slack als „the conversational interface for humans and agents to work together“.
Was entsteht, ist also vermutlich nicht eine einzige neue Oberfläche, sondern eine gemeinsame KI-Schicht unter mehreren Oberflächen. Damit verschiebt sich die Entscheidung. Sie lautet nicht, welches Unternehmens-GPT gekauft wird, und auch nicht bauen oder kaufen, sondern:
Welche KI-Schicht soll zwischen Mitarbeitenden und Systemen entstehen, und welche Teile davon müssen dauerhaft unter eigener Kontrolle bleiben?
Eine belastbare Antwort liefert bisher kein Anbieter. Als Arbeitsannahme trägt am ehesten: Dauerhaft gehören müssen einem Unternehmen die eigene fachliche Logik, die Governance, die Maßstäbe der Qualitätsmessung und die Fähigkeit, den Anbieter zu wechseln. Welche technischen Schichten selbst betrieben werden, ist eine Frage des Anwendungsfalls, nicht der Haltung.
In unserem Beispiel führte Miriams Hinweis dazu, dass drei Wochen lang Freigaben aufgeräumt wurden. Der Assistent wurde davon nicht besser. Das Unternehmen schon.
FOUNDIC.org ist werbefrei und ohne Bezahlschranke. Wenn dir dieser Beitrag etwas gebracht hat:  Lade uns auf einen Kaffee ein